mica-ppocr 1.2.6:Java OCR 选型三问
Java 后端做 OCR,比「谁的识别率高」更该先问三件事:给的是散落文字框还是能入库的业务字段、换台机器结果是否一致、装它要拖多少依赖。mica-ppocr 1.2.6 把这三件事做实了 —— 10 类证件直出字段、输出确定可复现、运行时只要 2 个 jar,纯 CPU 进百毫秒级,JDK 8 起步。
纯 ONNX Runtime · 零 PaddlePaddle · Java 8 起 · 10 类证件票据直出字段 · 输出确定可复现
先贴一段线上日志,这是最近的真实记录:
"POST /api/ocr/pdd HTTP/1.1" 200 ... req_time=0.312 upstream_time=0.181
"POST /api/ocr/pdd HTTP/1.1" 200 ... req_time=0.271 upstream_time=0.183
"POST /api/ocr/pdd HTTP/1.1" 200 ... req_time=0.265 upstream_time=0.184
#小程序:多多福袋帮 生产环境的 OCR 接口,腾讯轻量云 4 核、Linux,纯 CPU 推理,没有 GPU。近 2 小时 25 次请求,全部 200。OCR 链路本身 p50 200 ms,上面这三行是最快的三次(181 / 183 / 184 ms);算上客户端传输和网关,端到端 p50 290 ms。
这个接口背后没有云 OCR、没有 Python 服务、没有 GPU —— 4 核轻量云的纯 CPU 推理,就是一个 Spring Boot 应用加一个 jar。而这个 jar,JDK 8 就能跑。
但今天不想推销这个接口。真正想聊的是:Java 后端做 OCR,有三个问题比「谁的识别率高」重要得多,而市面上大多数方案在这三件事上是含糊的。
一、它给你的是一堆文字框,还是能直接入库的字段?
这是第一个问题,也是最耗时间的那个。
OCR 的原始输出是散落的文字框和文本。然后呢?「姓名」后面那个值在哪个框里?标签被 OCR 拆成「姓」和「名」两半怎么办?两个字段串行到同一行怎么切?换一种证件版式,整套规则重写一遍。
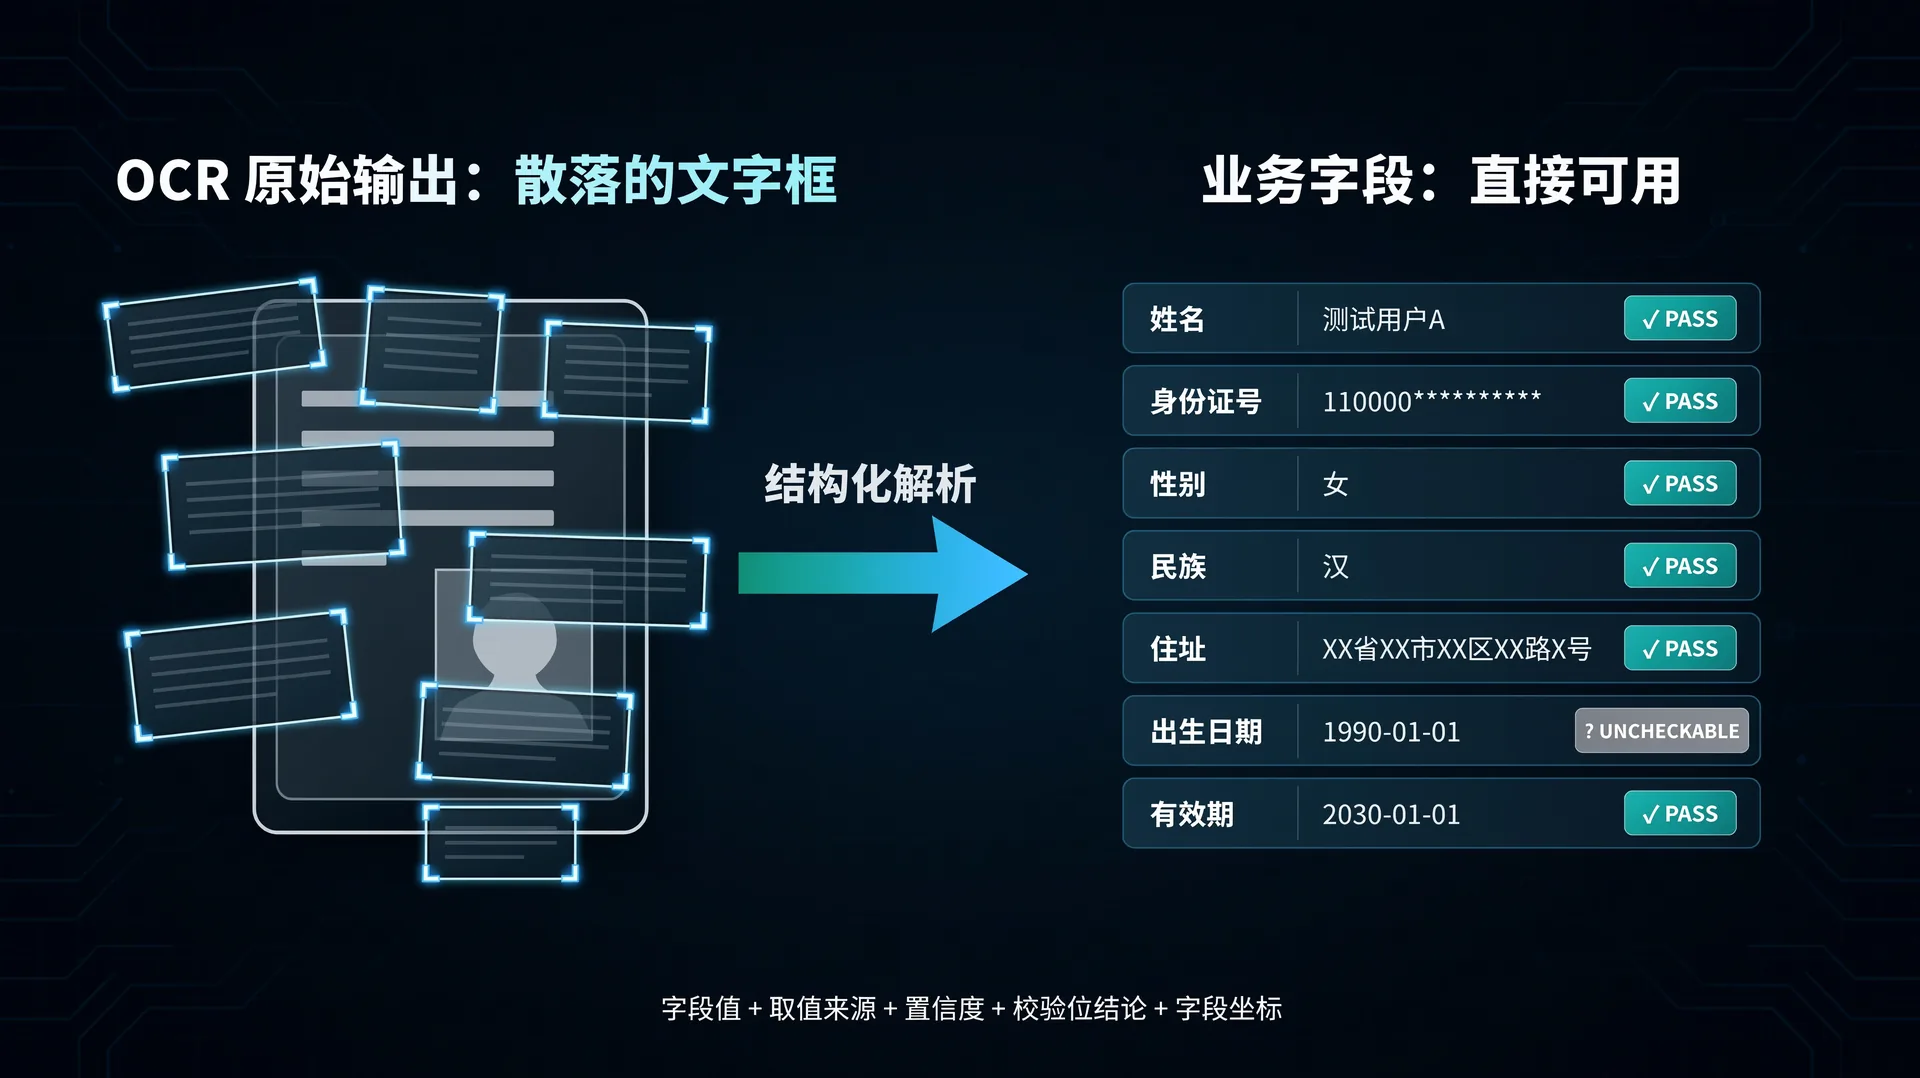
mica-ppocr 的做法是把这一步内置。10 类证件票据 —— 行驶证、身份证、银行卡、驾驶证、营业执照、发票、火车票、出租车票、户口本、拼多多福袋 —— 直接吐出业务字段:
@Autowired
private PPOcrTemplate ppocr;

@PostMapping("/ocr/vehicle")
public VehicleLicenseResult vehicle(@RequestParam MultipartFile file) throws IOException {
    return ppocr.vehicleLicense().parse(file.getBytes());
}
1.2.6 这一版,10 个解析器全部支持 fieldBoxes 了。 以前身份证、驾驶证、银行卡这三家是没有的,你拿到结果想在前端高亮「哪个框是车牌号」,得自己按文本二次匹配。现在字段值和坐标一起给你,画框是前端一行循环的事。
还有几个细节更值得说:
它会告诉你这个值从哪来、能不能信。 字段来源分五档 —— 标签命中、正则兜底、推导、回填、缺失,一目了然。校验位三态判定:PASS / FAIL / UNCHECKABLE。校验不过时置信度直接归零 —— 但字段值仍然保留,丢值对下游更糟。同时给 needsReview 和 reviewReasons,该不该人工复核显式交给你。
它不会把长数字串修成日期。 日期归一化以前会把 18 位身份证号「修复」成 1101-05-19 这种恰好合法的日期,还能通过形态校验拿到满置信度。现在只有「恰好 8 位数字」或「含日期分隔符」的文本才进修复流程。
还有一类坑叫「值明明在,就是取不出来」:数电票那种数值列右对齐的版面,明细金额 / 税额以前整列漏掉;银行卡「VALID THRU 12/25」被合成一框时有效期整条静默丢失。这些 1.2.6 都修了。
新单据怎么办? 写一份声明式 schema —— 字段名、标签、正则、校验规则、归一化,声明完就能抽,不用再实现解析器类。
二、换台服务器跑,结果还一样吗?
第二个问题,也是 Java OCR 最常被吐槽的地方:「本地能跑,CI 上跑不出」。
mica-ppocr 的答案是确定性:同一份输入,在任何机器、任何线程数下跑出来,结果完全一样。这不是调参调出来的,是几个决定堆出来的:
默认 CPU 单线程(intraOp = interOp = 1)、默认不开加速器 —— 绕开 GPU / CPU 的浮点差异,也绕开线程调度顺序对累加顺序的影响。
而且不开加速器不代表慢 —— 开头那台 4 核轻量云,纯 CPU 就跑进了百毫秒级。当然要 GPU 也行(换 onnxruntime_gpu + preferAccelerator(true)),但先把 CPU 这条路的确定性拿到手,通常比追 GPU 吞吐更划算。
1.2.6 把检测框坐标的整数化去掉了。 以前坐标是取整的近似值,现在小数坐标一路贯通到裁剪边界 —— 约 98% 的框位移 ≤3px。做像素级判断的下游,能感觉到这个差异。
PDF 双通道的坐标系也统一了。 同一份 PDF 里,「文本层抽出来的框」和「渲染后 OCR 的框」以前是整体错位的(一个按 point,一个按像素),1.2.6 把它们统一到渲染图像素坐标。
每个改动都有回归测试钉住 —— 44 张样图 × 10 个解析器比对,没有字段变成 null,6 个字段有单字抖动。
三、装它要拖进来多少东西?
第三个问题:部署账单。这个可以量化 —— mica-ppocr-core 的运行时依赖只有两个 jar:
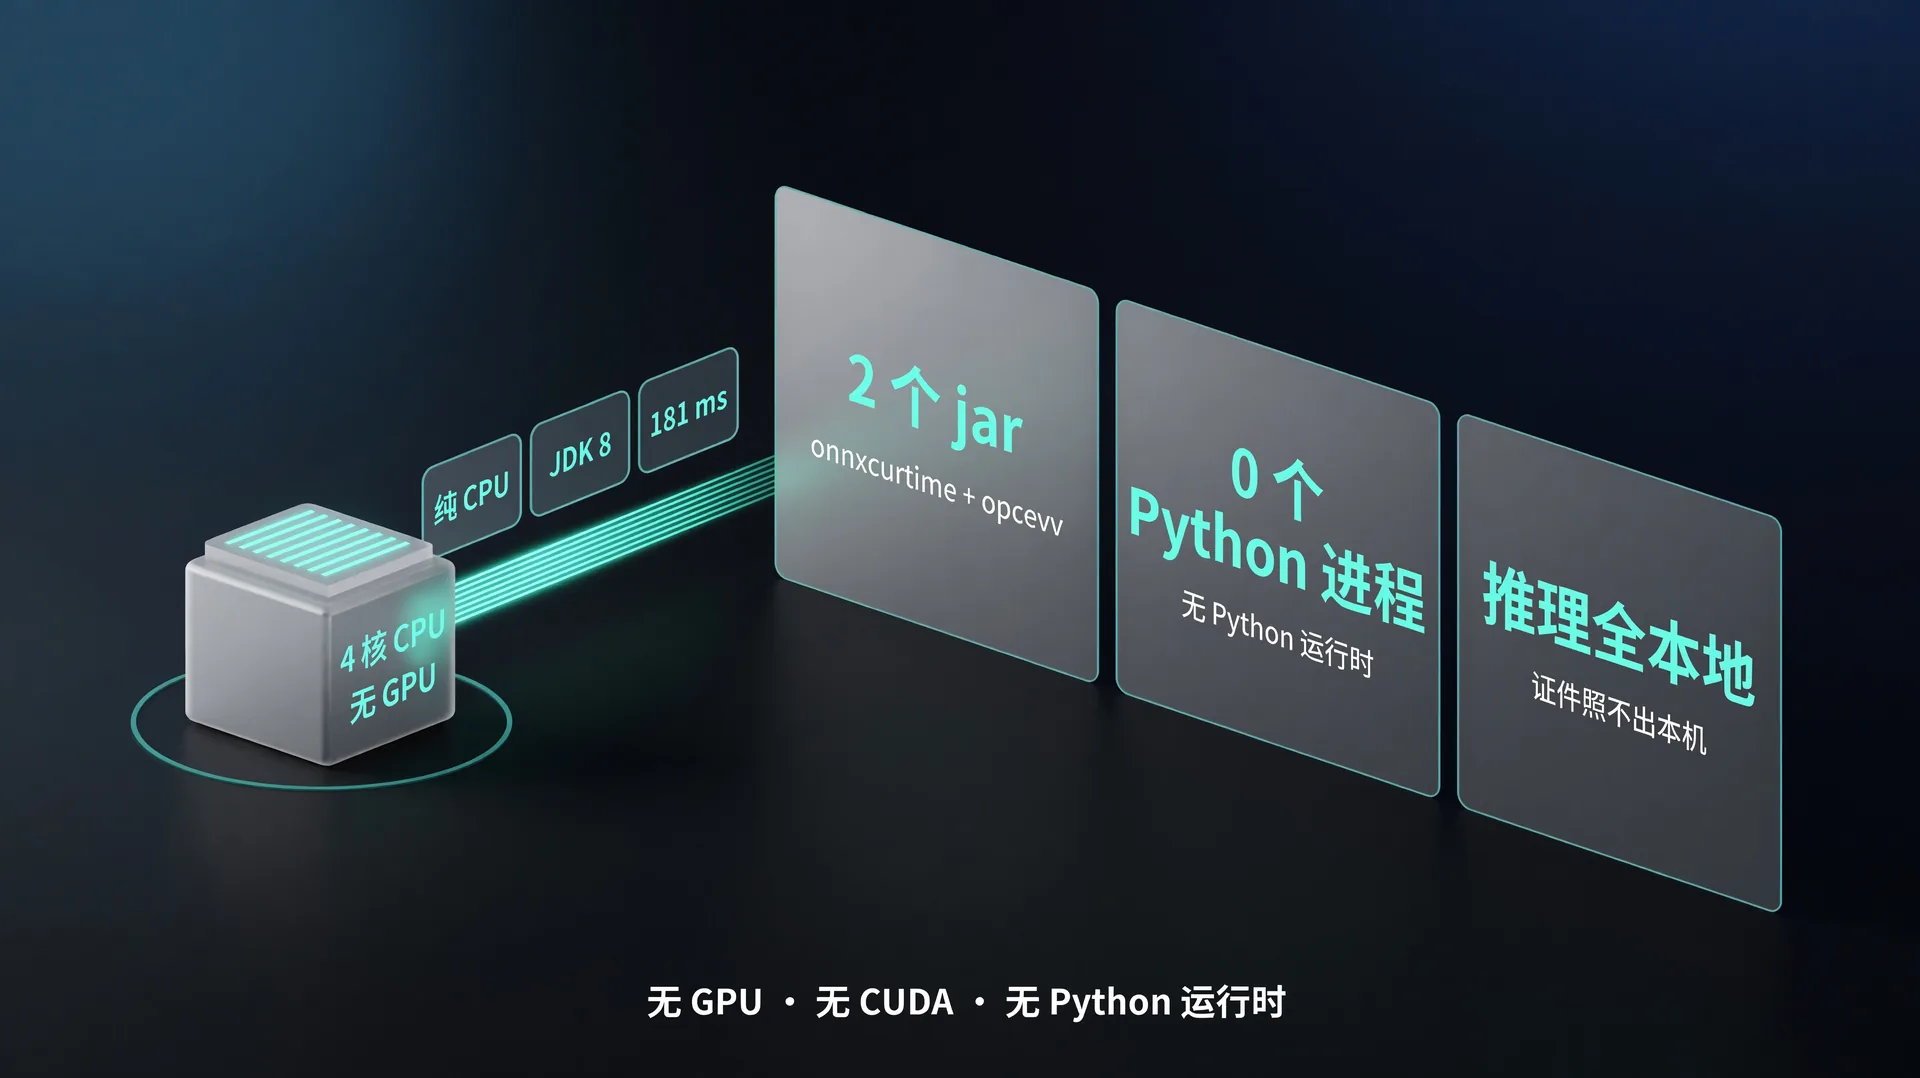
net.dreamlu:mica-ppocr-core:jar:1.2.6
+- com.microsoft.onnxruntime:onnxruntime:jar:1.18.0:compile
\- org.openpnp:opencv:jar:4.9.0-0:compile
mica-ppocr-structured 只依赖 core,不再引入任何第三方运行时依赖。pdfbox(连同 pdfbox-io / fontbox / commons-logging)标了 optional,只做图片 OCR 的项目不会被它传染。
1.2.6 还顺手把 JTS 移除了 —— 多边形偏移(unclip)改成纯 Java 实现,单次调用 5.34 → 1.63 μs、堆分配 12.7 KB → 2.7 KB,检测框坐标与识别文本逐位不变。运行时第三方几何库,现在归零。
内存账单也压下来了:
- 输出张量零拷贝读取 —— 每次 OCR 的堆分配降 32%~40%、峰值存活堆降 26%~46%,识别文本与置信度逐位不变
- 模型与 PDF 不再整份进堆 —— 堆上不再出现与模型等大的数组(medium 档 rec 模型约 73 MiB)
- 解析层正则全部预编译 —— 单次正则调用快 5.4 倍,解析耗时降约 22%,堆分配降 60%~68%
- 检测最大边长默认 4000 → 1920 —— 2K~4K 图的检测耗时大幅下降
还有一条对存量项目挺重要:JDK 8 起就能跑。 不是 Java 11+,也不是 17 —— 源码是按 Java 8 标准库编译校验的,Spring Boot 2.5~4.x 全通吃。老项目不用为了加个 OCR 功能就把 JDK 升上去。而且整个推理在本地 —— 证件照不出本机,不按次计费。
四、顺带说说 PDF:不该 OCR 的就别 OCR
很多方案对所有 PDF 都是「渲染成图 → 全部走 OCR」。慢,而且白白丢质量。
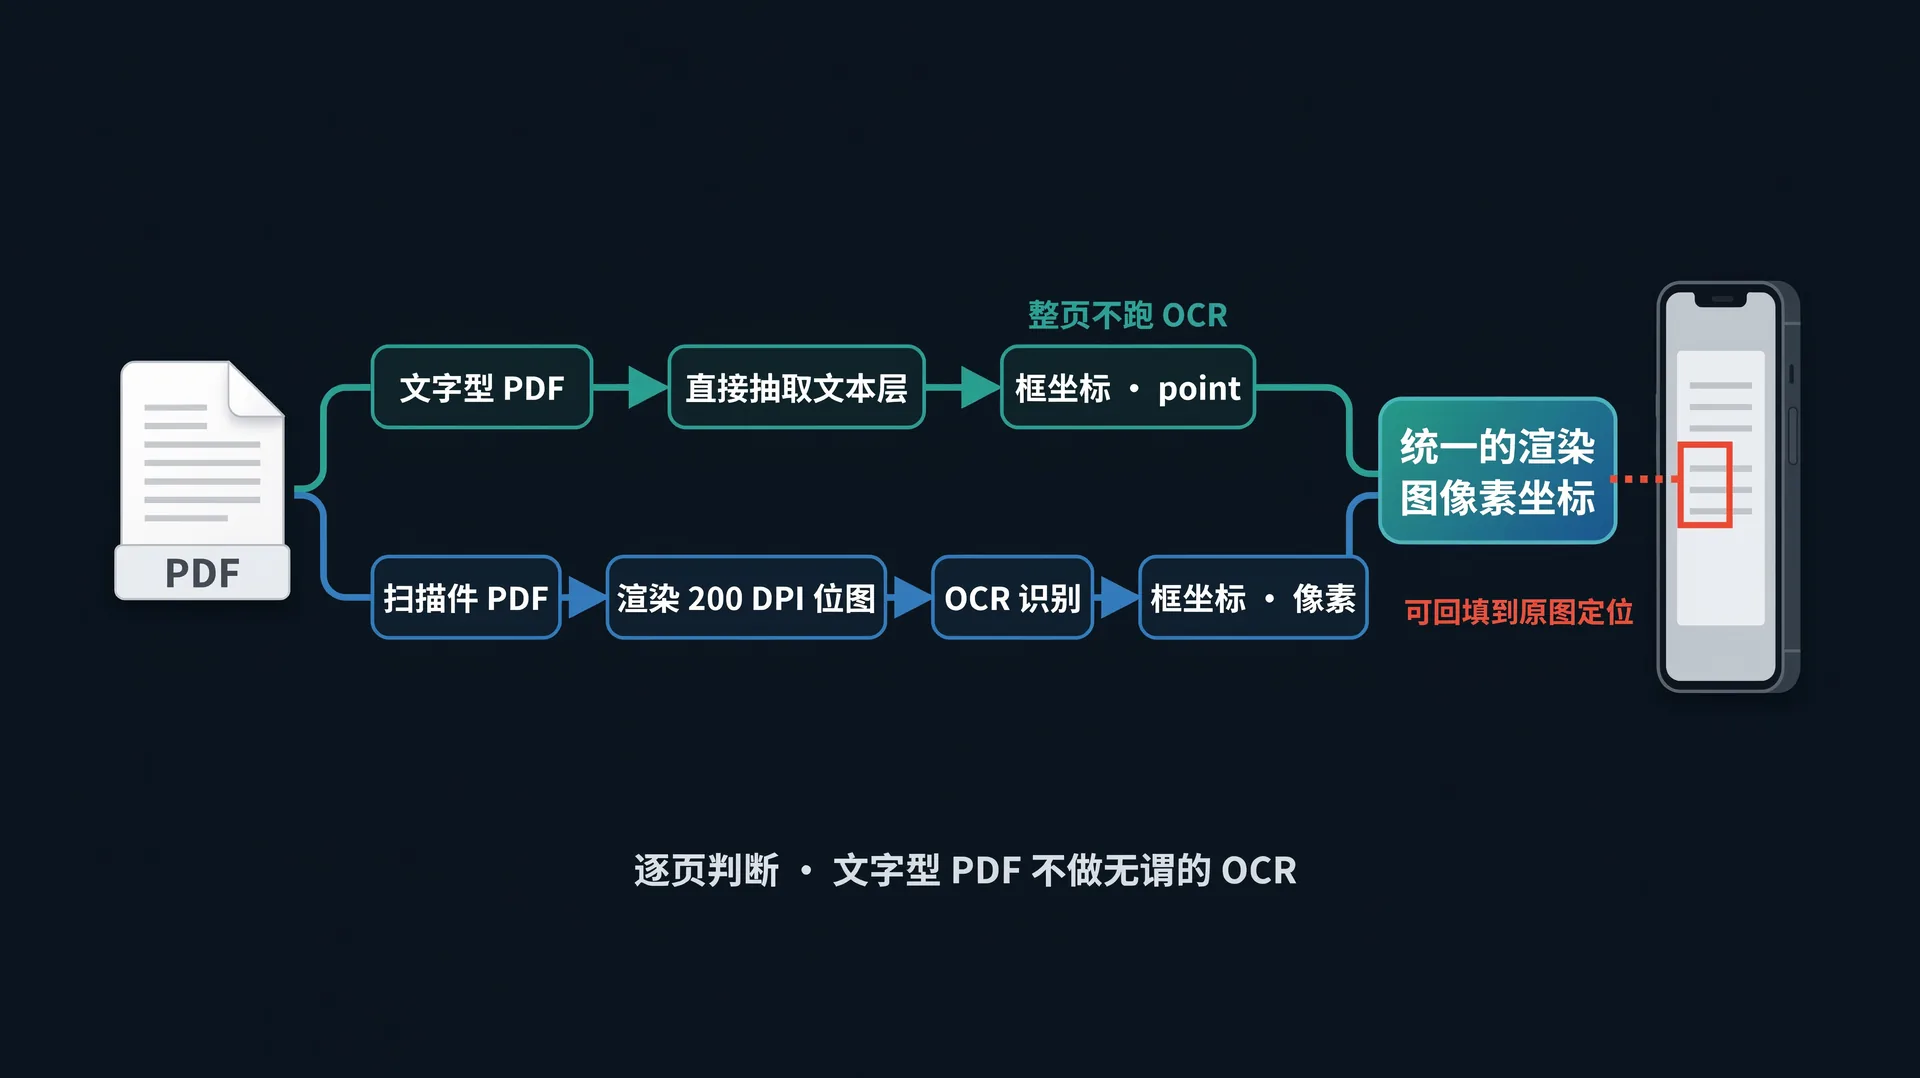
mica-ppocr 是逐页判断的:
- 先抽文本层,评估质量(字符数 ≥ 20、可读占比 ≥ 0.90)→ 达标就直接用文本层,整页不跑 OCR
- 不达标(扫描件)才渲染成位图(200 DPI 可配)→ 走完整 OCR 链路
两条通道的框最后统一到渲染图像素坐标,所以调用方拿任一页的框,都能直接对照同一张渲染图定位。
每页的结果都带 pageIndex 和 viaOcr 标记 —— 一份混合 PDF 里哪几页走了 OCR,一眼就知道。
五、什么时候别用它
选型文章不写边界就没意思了,这几条请先看完。
- 要处理 PDF 就自己加依赖 —— 显式引入
org.apache.pdfbox:pdfbox:3.0.8。没引入时run(byte[])收到 PDF 会抛IllegalStateException并指明要补哪个包,图片输入不受影响 - 单独引 core 的项目要自己引 slf4j-api —— 1.2.6 把 core 的 slf4j-api 改成
provided,避免给下游强塞 2.0.20(跟 Spring Boot 2.7 的 logback 不兼容,会让全站日志哑掉)。走 starter / plugin 不用管 - 默认检测分辨率是 1920 —— 你如果用
detLimitType = max且detLimitSideLen大于 1920,需要自己调大 - 有几处行为变更要复核 —— 检测框坐标会变;PDF 文本层
box坐标整体放大renderDpi / 72倍(200 DPI 下约 2.78×),按 point 解读的代码要调整;火车票与发票的金额货币符前缀恒为半角¥ - CPU arena 与内存模式优化默认是关闭的(v1.2.0 起,为解决动态分辨率下内存涨到 OOM)—— 只有输入分辨率固定、又追求极致吞吐时才值得开,吞吐约损 10%
六、上手其实很快
模型已经随仓库入库(models/ppocr-v6/),clone 完就能跑:
| 档次 | det | rec | 字符表 | 定位 |
|---|---|---|---|---|
| tiny | 1.7 MB | 4.3 MB | ~2855 字符 | 轻量优先,速度快 |
| small | 9.4 MB | 20.2 MB | ~2855 字符 | 速度与精度均衡,推荐默认 |
| medium | 59.2 MB | 73.0 MB | ~7180 字符 | 精度优先,覆盖更全字符集 |
原生库(ONNX Runtime / OpenCV,Windows / Linux / macOS)随 Maven 引入,不用手动装。
<dependency>
    <groupId>net.dreamlu</groupId>
    <artifactId>mica-ppocr-spring-boot-starter</artifactId>
    <version>1.2.6</version>
</dependency>
数据口径说明
正文里出现了两类数字,来源不同,别混着看。
线上真实数据(绝对值,可直接引用)
| 项 | 说明 |
|---|---|
| 来源 | nginx 访问日志,POST /api/ocr/pdd |
| 时间 | 2026-11-14 09:08:38 ~ 11:02:15 |
| 样本 | 25 次请求,HTTP 状态码全部 200 |
| 机器 | 腾讯轻量云 4 核,Linux |
| 负载 | 拼多多福袋图,1200×1500 |
req_time | nginx 端到端(含客户端传输与网关开销),p50 290 ms |
upstream_time | 后端 OCR 处理耗时,p50 200 ms |
| 局限 | 样本量小、单一负载、时段分散;不代表并发吞吐能力,仅用于说明单请求耗时水位 |
本地 benchmark(相对值,不可当线上耗时引用)
- 同一台机器、同一套参数的前后对比(开发机、Windows、单线程)
- 绝对值随机器与线程配置浮动,只应引用降幅
- 正文里「行驶证 1638 → 951 ms」「DB 后处理 10.2 → 6.8 ms」这类数字属此类
依赖树:由 mvn dependency:tree -Dscope=runtime 实测导出,非手写。
写在最后
回到开头那三个问题:
它给的是框,还是字段? —— 10 类证件票据直出字段,还带来源、置信度、校验位结论和坐标。 换台机器结果还一样吗? —— 输出确定性,检测框坐标小数贯通,换机器不飘。 装它要拖进来多少东西? —— 运行时 2 个 jar,无 Python 生态,JDK 8 起,纯 CPU 百毫秒级,证件照不出本机。
哪个问题是你正在头疼的,值得花五分钟看看:
- Gitee:gitee.com/dreamlu/mica-ppocr
- GitHub:github.com/lets-mica/mica-ppocr
有踩坑、或者想要某个单据的解析器,都欢迎来 Issue 里聊 —— 想听的是「你那套证件是啥版式」这种具体问题。
你们团队选 OCR,最头疼的是哪个问题?我猜大多数人是第一个 —— 识别完那堆正则。
相关链接
- mica-ppocr 文档:依赖坐标、配置项与 10 类解析器清单
- 完整变更记录
- Gitee 仓库 · GitHub 仓库
- 站内相关:mica-ppocr 1.2.4:OCR 预处理内存砍半,检测提速 2.6 倍