mica-ppocr 1.2.4:OCR 预处理内存砍半,检测提速 2.6 倍
预处理堆内存砍掉一半、检测提速 2.6 倍。这一版还清掉了两类「写了却不生效」「关了却关不掉」的问题:PDF 双通道的配置终于传到了引擎,关掉总开关不再启动失败,海报类版面也有了声明检测参数的口子。
上一版本 v1.2.3(2026-09-12) · 发布于 2026-10-25
这一版把预处理内存砍掉一半、检测提速 2.6 倍,顺手清掉了两类「写了却不生效」「关了却关不掉」的问题:PDF 双通道的配置终于传到了引擎,mica.ai.ppocr.enabled=false 之后应用也能正常启动;海报类版面也有了声明检测参数的口子。
变更总览
| 模块 | 变更 | 类型 |
|---|---|---|
mica-ppocr-core | 预处理内存融合(堆 -50%、检测提速 2.6×);mica.ai.ppocr.pdf.* 接通引擎;输入校验修复 | perf / feat / fix |
mica-ppocr-structured | 热路径分配优化;新增 detParams() 钩子;拼多多福袋类型识别 | perf / feat |
mica-ppocr-spring-boot-starter | 总开关闸门补齐;PDF 配置默认值对齐 | fix |
mica-ppocr-solon-plugin | 总开关闸门对齐;补注册 PdfAutoConfiguration | fix |
一、预处理内存砍半,检测提速 2.6 倍
三处预处理(det / rec / doc_ori)改成「归一化结果直接写入 CHW / NCHW 输出数组」,不再 materialize 中间 HWC 数组,也不再生成 CV_32F 中间 Mat。
| 场景 | 堆分配 | 耗时 |
|---|---|---|
| det 预处理(3000×4000 图) | 275 MB → 137 MB(-50%) | 110 ms → 42 ms(2.6×) |
| rec 预处理(50 框 × 1200px 宽) | 79.1 MB → 39.8 MB(-50%) | 21.1 ms → 15.9 ms(-25%) |
另省约 40 MB native 内存。
对使用者的实际影响:预处理一度是大图 OCR 的内存大头 —— 一张 3000×4000 的图,光归一化就吃掉 275 MB 堆。砍掉一半之后,Docker 里给容器的内存配额、或者本地跑批处理时的峰值占用都跟着松一截。
数值一个字节都没变
uint8 → CV_32F 与 uint8 → 提升为 float 在 0~255 上逐位相同,所以「先转 float 再算」与「直接提升再算」结果一致 —— 这正是省掉 CV_32F 中间 Mat 的依据。
三个预处理测试各保留了一个 reference* 方法(旧实现的副本)做 assertArrayEquals 逐位比对。后续再做优化时,按同样模式把参照实现留在测试里 —— 那是数值真相源,不是死代码。
顺手修掉的 native 内存滞留
文档方向预处理的中心裁剪子 Mat 视图与 resize 本体原先释放顺序颠倒(先放本体、后放视图),现改为「先视图、后本体」,引用计数 2 → 1 → 0 依次归零。
写反了不会立刻报错,只是 native 缓冲滞留到 GC —— 长时间跑批处理时,这是一笔看不见的账。
二、PDF 通道配置接通了
背景
v1.2.2 引入 PDF 双通道(文本层坐标抽取 + 渲染位图 OCR)时,mica.ai.ppocr.pdf.* 只停留在配置对象上,没有传到引擎。引擎的 PDF 入口始终用 PdfOcrConfig.defaults()。
实际表现是:render-dpi 调成 300 没反应,min-text-chars 调成 10 没反应 —— 参数写得对,行为纹丝不动。
现在
PPOcrV6Config 新增 pdfOcrConfig 字段,PPOcrV6Engine 构造期取它,PDF 入口(run(byte[]) / run(Path) 嗅探到 %PDF- 时)实际消费。图片通道不受影响。
| 参数 | 默认值 | 作用 |
|---|---|---|
render-dpi | 200 | 渲染通道输出 DPI。扫描件内嵌位图有原始分辨率,超过原图信息量的重采样只会放大噪声,发票 / 证件类 200~300 为宜 |
min-text-chars | 20 | 文本层可用所需的最小非空白字符数,低于则判定无文本层 |
min-readable-ratio | 0.90 | 文本层可读字符占比下限。缺 ToUnicode 映射的 CID 字体会抽出一批私有区字符,拉低占比 |
force-ocr | false | 跳过文本层探测,所有页面强制走渲染 + OCR,用于竖排、页面旋转等文本层坐标不可信的版式 |
YAML 写法不变:
mica:
  ai:
    ppocr:
      pdf:
        enabled: true
        render-dpi: 200
        min-text-chars: 20
        min-readable-ratio: 0.90
        force-ocr: false
也可以直接用代码覆盖 —— 自定义一个 PdfOcrConfig Bean 即可(Spring @Bean / Solon @Configuration),引擎会直接采用它,无需再改 yml。
两处需要留意的行为变更
PdfOcrConfigBean 现在就是引擎使用的配置,不再是只读副本。此前业务方自定义同名 Bean 会被静默忽略(容器里是自定义值、引擎仍用 yml 或默认值),现在会直接改变引擎行为。pdf.enabled=false时 Bean 仍然存在,取PdfOcrConfig.defaults()(此前是不注册这个 Bean)。两端都容忍该 Bean 缺失(回落到 yml 派生值),不会因为排除自动配置类而启动失败。
两端默认值对齐了
v1.2.3 时 Starter 暴露的默认值是 minTextChars=10 / minReadableRatio=0.6,而引擎实际在用的是 20 / 0.90 —— 文档写 10、引擎跑 20。两端现已统一为 20 / 0.90,不配置即保持原有行为。
Solon 端此前还漏了 PdfAutoConfiguration 的注册,压根拿不到 PdfOcrConfig Bean,本次补上。
三、关掉总开关不再启动失败
背景
Spring 端的 StructuredParserAutoConfiguration 漏挂了 mica.ai.ppocr.enabled 这个闸门。
10 个解析器 Bean 都以 PPOcrV6Engine 为构造参数注入。主配置被关掉 ⇒ 引擎 Bean 不存在 ⇒ 抛 NoSuchBeanDefinitionException ⇒ 容器 refresh 直接失败。
也就是说,想用这个开关在某些环境关掉 OCR,结果应用启动失败。
现在
三个配置类统一挂到同一个闸门:
- Spring:
@ConditionalOnProperty(prefix = "mica.ai.ppocr", name = "enabled", havingValue = "true", matchIfMissing = true) - Solon:
@Condition(onExpression = "${mica.ai.ppocr.enabled:true} == true")
关闭时容器里不注册任何 PP-OCR 功能 Bean(引擎 / 10 个解析器 / PPOcrTemplate / 配置对象),应用照常启动,可用于「同一套代码在部分环境不启用 OCR」的场景。
⚠️ 行为变更:关闭时两端都不再留下 PdfOcrConfig Bean —— Spring 端此前会残留一个(它的 PdfAutoConfiguration 只挂在 mica.ai.ppocr.pdf.enabled 上),Solon 端此前压根没注册过 PdfAutoConfiguration。
例外:OpenCVNativeLoader 不受该开关约束,OpenCV 原生库仍会加载。业务方若自行使用 org.opencv.*,需知晓这一点。
四、按版面类型声明 DB 检测参数
一个容易被误判的现象
海报类版面(大字号稀疏数字 + 满屏背景水印),rec 单独跑同一张图完全正确,det 却一个框都没给。
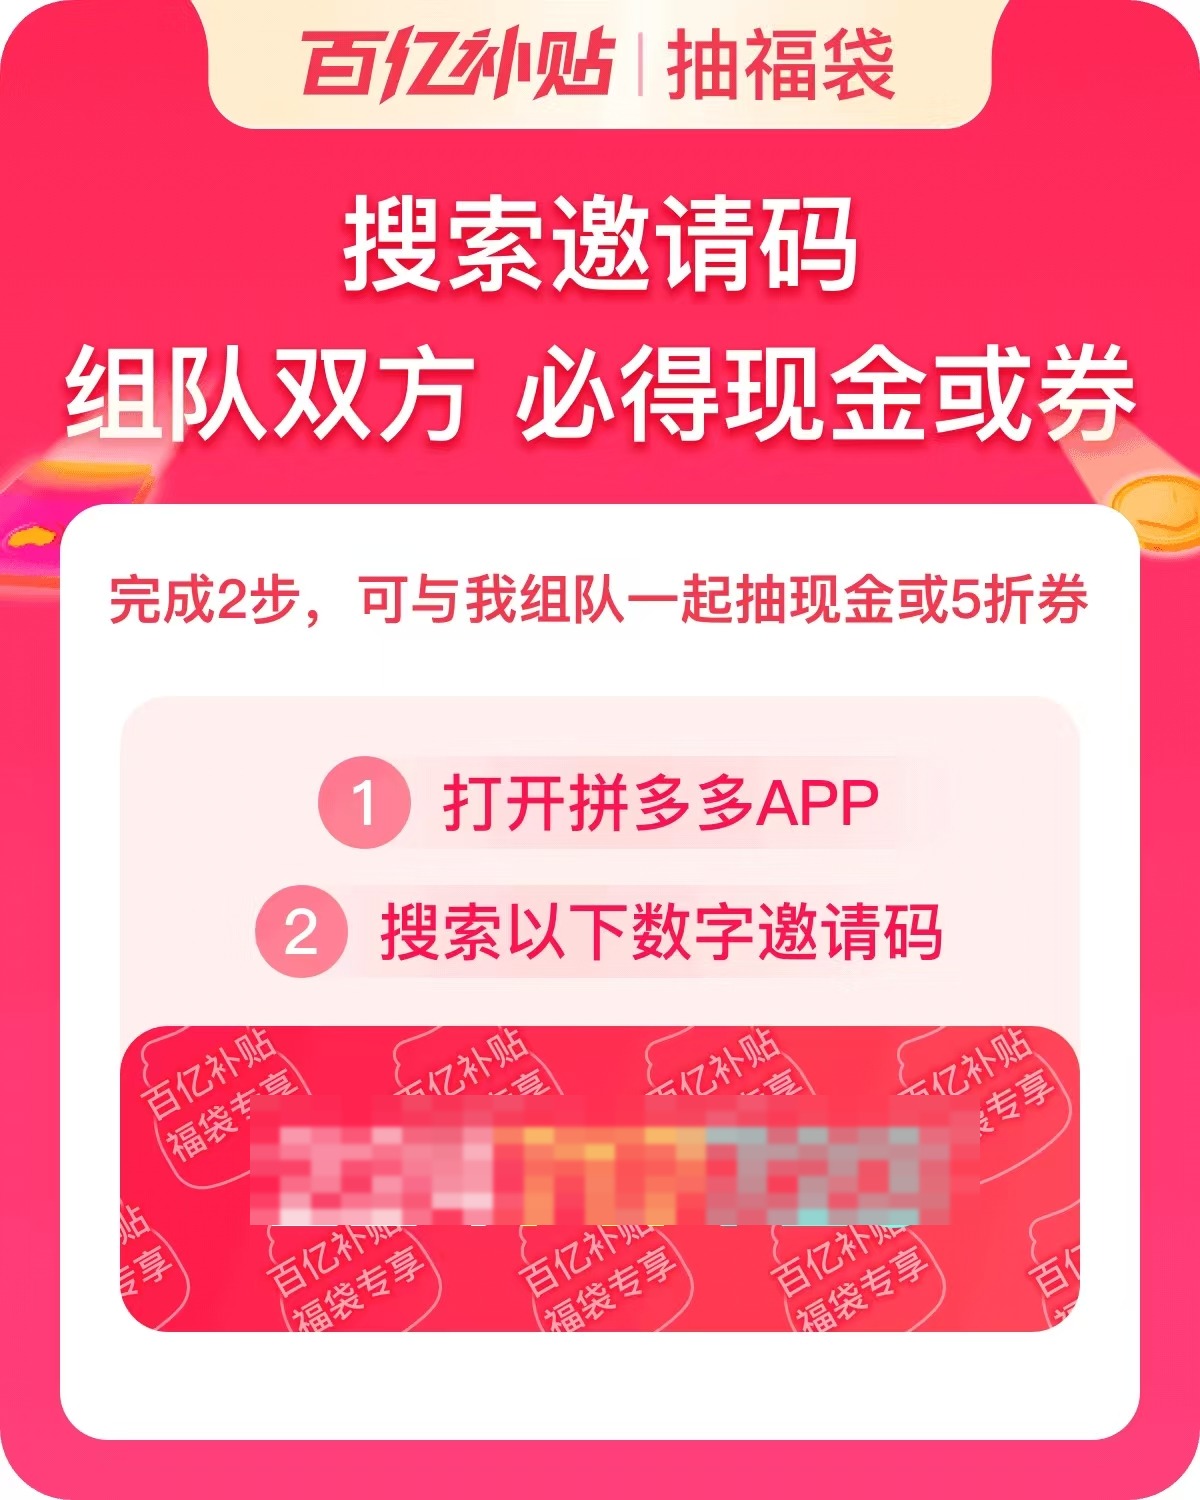
根因不在模型,而在 DB 后处理:boxScore 是框(minAreaRect)内概率图的平均值,本质是「框内文字像素占比」。这种版面上 DB 把 8 位大数字和背景水印连成一个整体轮廓,框内真正的笔画只占约 42%,低于默认 detBoxThresh=0.6 被直接丢弃。
模型看见了,是后处理过滤掉的。 排查时先把 det 的概率图 dump 成 PNG(目标区域纯白高响应即模型看见了),再复刻 DbPostProcessor.extractBoxes 逐条打印 origRect / minSideLen / score / PASS|DROP(原因),就能定位到是哪一条判据把它过滤掉了。
解法:解析器自己声明检测参数
BaseStructuredParser 新增 detParams() 钩子(默认 null = 引擎默认),一站式 parse(...) 自动带上,显式传入的 DbDetParams 优先。解析器可以按自己的版面类型声明专属参数,不影响同引擎上的其它解析器。
public class MyPosterParser extends BaseStructuredParser<MyResult> {

	@Override
	protected DbDetParams detParams() {
		// 放宽 boxThresh 让稀疏大字符框过关,同时收紧 unclipRatio 避免外扩把上下水印卷进来
		return DbDetParams.of(0.3f, 0.4f, 1.0f);
	}

	// ...
}
参数顺序是 DbDetParams.of(thresh, boxThresh, unclipRatio)。已落地在 PddLuckyBagParser.DET_PARAMS(0.3f / 0.4f / 1.0f)。
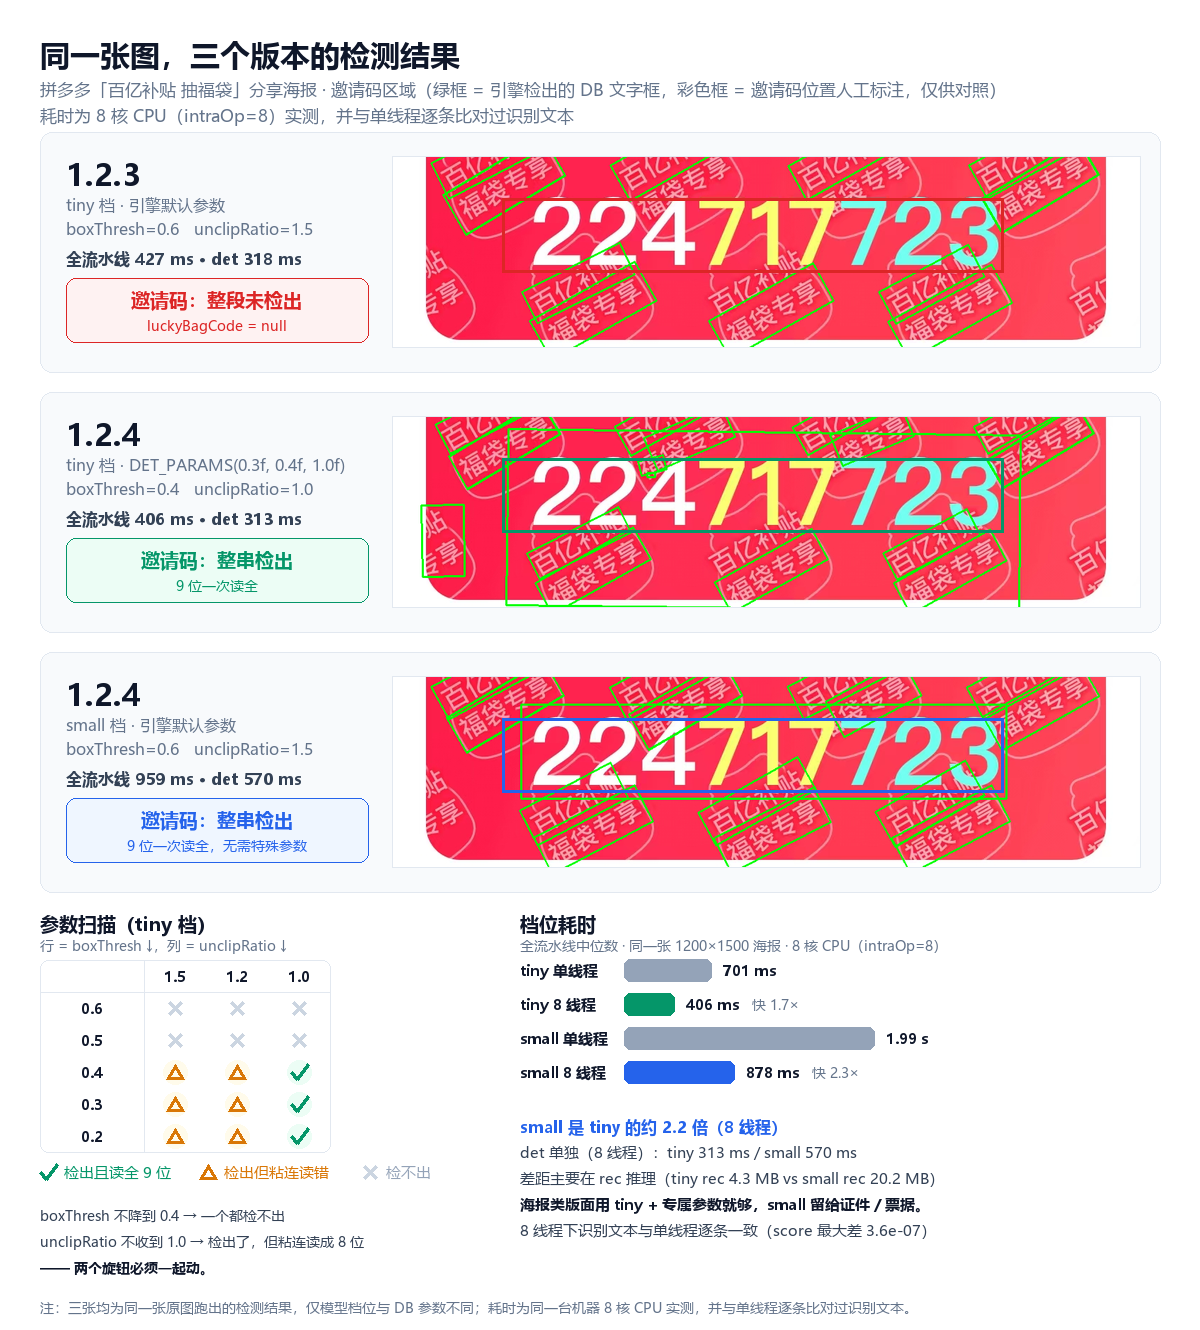
但别照抄这个参数
证件 / 票据类版面沿用引擎默认(min/64 + 0.6/1.5)。
- 不要改成
detLimitType=max+ 大detLimitSideLen—— 那会缩小整图,小字成片漏检(实测出租车票框数 55 → 26)。 - 不要靠调大
DbDetParams.minSize过滤碎片 —— 会连小字标签一起丢(如行驶证「所有人」变null)。
五、拼多多福袋类型识别
PddLuckyBagResult 新增 getType(),返回 PddLuckyBagType。两类分享图版式几乎一致(搜索邀请码 → 组队双方必得 → 大字号邀请码),仅靠文案区分:
| 枚举 | 含义 | 标题 | 口号 |
|---|---|---|---|
LUCKY_BAG | 福袋券 | 百亿补贴 抽福袋 | 组队双方 必得现金或券 |
FRUIT | 水果券 | 百亿补贴 水果分享券 | 组队双方 必得水果券 |
UNKNOWN | 无法判定 | 特征文案缺失(如只识别出邀请码数字框) | — |
fieldBoxes 同步回填 type 关键框。
六、其他修复与优化
- 识别 / 文档方向预处理显式校验输入为 8bit 3 通道:归一化按「每像素 3 字节」逐行读,而
Mat.get(row, 0, byte[])是从(row, 0)起连续读满数组长度 —— 通道数 < 3 会跨行读(把相邻行数据当本行像素),> 3 会通道步长错位。OpenCV 虽有「缓冲长度须为通道数整数倍」的前置校验,但 1 通道(灰度图)恒能绕过。旧实现越界即抛ArrayIndexOutOfBoundsException,故障模式由「立刻报错」退化为「静默产出错误张量」,现改为显式抛IllegalArgumentException。 MemoryLeakReproTest误报:判据参考点由 round 5 改为max(round 5, round 10),并移除stabilizeJvmMemory()的早退守卫。round 5 紧跟强制 GC,是堆刚被 uncommit 的人为凹点,后续正常回升被算成「增长」;实测误报样本 round 20 仍比 baseline 低 26.8 MB,却因以 round 5 为参考被判成 +87 MB 泄漏。- 结构化解析热路径分配优化:火车票解析器 3 处
Pattern.compile提为类常量;户口本解析器标签片段数组提为类常量(消除逐框每次约 110 个 String 引用分配);银行卡持卡人反查 O(n²) → O(n)(语义不变)。 - 死代码清理:
Offset.toFloat,以及 PDF 通道三个无detParams的私有重载。
升级指引
<dependency>
    <groupId>net.dreamlu</groupId>
    <artifactId>mica-ppocr-spring-boot-starter</artifactId>
    <version>1.2.4</version>
</dependency>
Solon 用户换 mica-ppocr-solon-plugin,纯 Java 用户换 mica-ppocr-core + mica-ppocr-structured。用法与依赖坐标详见 mica-ppocr 文档。
升级前必读:行为变更汇总
| 变更 | 影响 | 应对 |
|---|---|---|
mica.ai.ppocr.pdf.* 真的生效了 | 之前靠改 yml 调 PDF 参数的用户会发现行为变了 —— 之前根本没生效 | 不配置即保持原行为;默认值两端已对齐 |
PdfOcrConfig Bean 会被引擎直接采用 | 自定义同名 Bean 会改变引擎行为,此前是静默忽略 | 检查自定义 Bean 是否符合预期 |
pdf.enabled=false 时 Bean 仍存在 | 取默认值 | 如依赖 Bean 缺失做判断,需调整 |
mica.ai.ppocr.enabled=false 时不再留下 PdfOcrConfig Bean | 此前 Spring 会残留一个 | 按需改成读配置属性而非读 Bean |
识别 / 文档方向预处理对非 8bit 3 通道 Mat 抛 IllegalArgumentException | 此前要么越界异常,要么静默产出错误张量 | 传入前先转成 CV_8UC3 |
兼容性
- Java 8 兼容不变,运行依赖字节码均为 major 52。
- 依赖版本:onnxruntime 1.18.0 / opencv 4.9.0-0 / jts-core 1.20.0 / pdfbox 3.0.8 / slf4j 2.0.20 / spring-boot 2.7.18 / mica-auto 2.3.5 / solon 4.1.1。
- 本版实际升级的依赖只有两项:slf4j 2.0.19 → 2.0.20、solon 4.1.0 → 4.1.1(均为小版本,向后兼容)。其余依赖版本未动。
- Spring Boot Starter 与 Solon 插件能力对齐,类名一一对应。
验证情况
在 v1.2.4 发布提交(8f13fc1)上跑通全量构建与测试(mvn package -Dmaven.compiler.release=8),共 311 个测试用例,0 失败、0 错误(core 1 个跳过)。
本次新增测试:
PdfOcrConfigWiringTest(core)、PdfOcrConfigSpringWiringTest、PdfOcrConfigSolonWiringTest—— PDF 配置接线StructuredParserAutoConfigurationTest(Spring / Solon 各一)—— 总开关闸门DetectionPreprocessorTest/RecognitionPreprocessorTest/DocOrientationPreprocessorTest的reference*逐位比对PddLuckyBagParserTest/PddLuckyBagIntegrationTest—— 福袋类型与检测参数