mica-ai:13 个 ONNX 能力可拼装
纯 Java 8+ 的本地 AI SDK:13 个 ONNX 小模型覆盖人脸核身、文件类型、车牌、版面分析、抠图、超分、验证码。零 Python 进程、数据不出内网,能力之间可以拼成完整的业务链路。
纯 Java 8+ · 零 Python 进程 · 零云端调用 · 模型随仓库分发 · Apache 2.0 商用友好
做业务系统的 Java 同学,需求单上总会出现几个「不太像 Java 该干的事」:注册要人脸核身,上传要识别真实文件类型,档案要按版面切块,图片要抠图要超分,停车场要读车牌,后台登录要自动过验证码。
传统只有两条路 —— 调云端 API,数据出域、按次计费、多一次网络往返;或者自己养一套 Python 推理服务,FastAPI + PyTorch + CUDA,多一门语言、多一套部署、多一份运维。
mica-ai 走的是第三条:模型以 ONNX 格式随仓库分发,通过 ONNX Runtime 在 JVM 内推理,能力按模块拆开,用哪个引哪个。
一、先算清楚它省掉了什么
| 维度 | 云端 API | 自建 Python 服务 | mica-ai |
|---|---|---|---|
| 数据边界 | 出域 | 内网 | 内网,不出 JVM |
| 计费 | 按调用次数 | 机器 + 人力 | 一次性部署 |
| 部署形态 | HTTP 依赖 | 独立进程 + 模型 + CUDA | 一个 jar 里的依赖 |
| 技术栈 | Java + HTTP | Java + Python | 只有 Java |
| 模型来源 | 服务方定 | 自己训 / 自己转 | 随仓库分发,可换同族 |
代价也要讲清楚:小模型的能力上限摆在那里。它替代不了大模型(LLM),也不适合 GPU 集群级吞吐的训练场景 —— mica-ai 的定位是「本地小模型能力件」,需要 GPU 时 ONNX Runtime 可以切 CUDA,但架构目标始终是轻量落地。
二、13 个能力模块
| 模块 | 能力 | 底层模型 | 入库大小 |
|---|---|---|---|
mica-ai-face | 人脸检测 / 128d 特征 / 活体 / 头像与证件提取 | YuNet + SFace + MiniFASNetV2 | 各 < 5 MB |
mica-ai-filetype | 文件类型识别(214 类) | Google Magika standard_v3_3 | ~10 MB |
mica-ai-plate | 中国车牌检测 + 识别 + 判型 | HyperLPR3 | 各 < 5 MB |
mica-ai-layout | 文档版面分析 + 阅读顺序 | PP-DocLayoutV3 | 125 MB(外置) |
mica-ai-matting | U²-Net 族通用抠图 | u2netp | 4.36 MB |
mica-ai-humanseg | 人像分割 | PP-HumanSeg V2-Lite | 5.88 MB |
mica-ai-textline | 文本行方向分类(0° / 180°) | PP-LCNet_x1_0 | 6.46 MB |
mica-ai-classify | PULC 通用图像分类(Top-K / 多标签) | text_image_orientation 等 4 个 | 4–7 MB |
mica-ai-detect | 通用目标检测(COCO 80 类) | NanoDet-Plus / YOLOX-s | 3.6 / 34 MB |
mica-ai-track | ByteTrack 多目标跟踪(纯算法,零模型) | — | 0 MB |
mica-ai-docalign | 文档角点检测 + 透视矫正 | DocAligner lcnet100 | 4.55 MB |
mica-ai-enhance | 图像 4× 超分(tile 推理) | Real-ESRGAN | 2.33 MB |
mica-ai-captcha | 通用验证码识别(CRNN + CTC) | ddddocr | 12.98 MB |
模块边界就是依赖边界。 引 mica-ai-face 不会把 mica-ai-layout 那 125 MB 的版面模型拖进来,也不会把只跑车牌场景用不到的验证码模型打进产物 —— 每个模块独立引依赖、独立配置、独立启停。
这些模块也不是玩具:每个模块的集成测试都会加载真实 ONNX 模型跑完整推理,兼作 I/O 契约回归,保证模型能加载、输入输出形状与语义没漂。
三、核心模块零 Spring 依赖
mica-ai-*-core 不依赖 Spring,任何 Java 8 进程都能直接用,try-with-resources 即用即关。以人脸模块为例,一次「检测 → 5 点对齐 → 128 维特征」:
nu.pattern.OpenCV.loadLocally();   // 非 Spring 环境需先加载 OpenCV 原生库

ModelConfig config = ModelConfig.builder()
        .detectionModelPath("models/face_detection_yunet_2023mar.onnx")
        .recognitionModelPath("models/face_recognition_sface_2021dec.onnx")
        .build();

try (ModelManager manager = ModelManager.create(config)) {
    FaceDetector detector = new FaceDetector(manager);
    FaceAligner aligner = new FaceAligner();
    FeatureExtractor extractor = new FeatureExtractor(manager);

    Mat img = Imgcodecs.imread("group.jpg");
    for (FaceBox box : detector.detect(img)) {
        try (Mat aligned = aligner.align(img, box)) {
            float[] feature = extractor.extract(aligned);   // 128d,已 L2 归一化
            // 入库后与库内向量点积即余弦相似度,SFace 经验阈值 0.35
        }
    }
    img.release();
}
ModelManager 是 AutoCloseable,管着三个 ONNX Session;入口统一是 OpenCV Mat,没有 BufferedImage 重载 —— 这一点在接存量系统时要先想清楚,别指望它帮你做图像格式转换。
四、Spring Boot 项目只多一段 YAML
引入 mica-ai-face-spring-boot-starter 后自动装配,模型路径统一挂在 model 下:
mica:
  ai:
    face:
      enabled: true
      model:
        detection:
          path: classpath:models/face_detection_yunet_2023mar.onnx      # 必填
        recognition:
          path: classpath:models/face_recognition_sface_2021dec.onnx    # 必填
        liveness:
          path: classpath:models/2.7_80x80_MiniFASNetV2.onnx            # liveness.enabled=true 时必填
注入的就不是「一个万能 Service」,而是按职责拆开的引擎 Bean,业务层想用哪一环就注入哪一环:
@Service
@RequiredArgsConstructor
public class FaceEnrollService {

    private final FaceDetector detector;        // YuNet 检测
    private final FaceAligner aligner;          // 5 关键点仿射
    private final FeatureExtractor extractor;   // SFace 128d
    private final LivenessDetector liveness;    // MiniFASNetV2(启用后可用)
    private final CardExtractor cardExtractor;  // 证件卡片提取

    public float[] enroll(Mat image) {
        FaceBox box = detector.detect(image).get(0);
        try (Mat aligned = aligner.align(image, box)) {
            return extractor.extract(aligned);
        }
    }
}
Starter 侧全部走 @ConditionalOnMissingBean:自己声明同类型 Bean 即可替换默认实现,业务代码零改动。enabled=false 时不装配任何 face Bean;model.detection.path 缺了启动直接 fail-fast,不会跑到线上才报错。
五、能力是能拼的
单模块能解决的事其实有限,真正的价值在于把它们串成业务链路 —— 四条典型拼法:
- 人脸核身:
mica-ai-face做检测 → 5 点对齐 → 128d 特征,活体由LivenessDetector逐帧打分;清晰度门控是ImageUtils里的工具方法,不额外引模块 - 档案数字化:
mica-ai-docalign透视矫正 →mica-ai-enhance4× 超分 →mica-ai-layout版面分析 + 阅读顺序 - 上传治理:
mica-ai-filetype判真实类型(不信后缀名)→mica-ai-classify判方向并转正 →mica-ai-matting抠主体 - 安防监控:
mica-ai-detect目标检测 →mica-ai-trackByteTrack 跨帧关联 →mica-ai-humanseg人像分割
拼的时候不用改代码:串起来的是各模块的公开 API,Mat 进 Mat 出,上一环的输出就是下一环的输入。哪一环效果不够,换同族模型(改 model-path)或换一个模块,调用方不动。
六、示例工程跑起来看效果
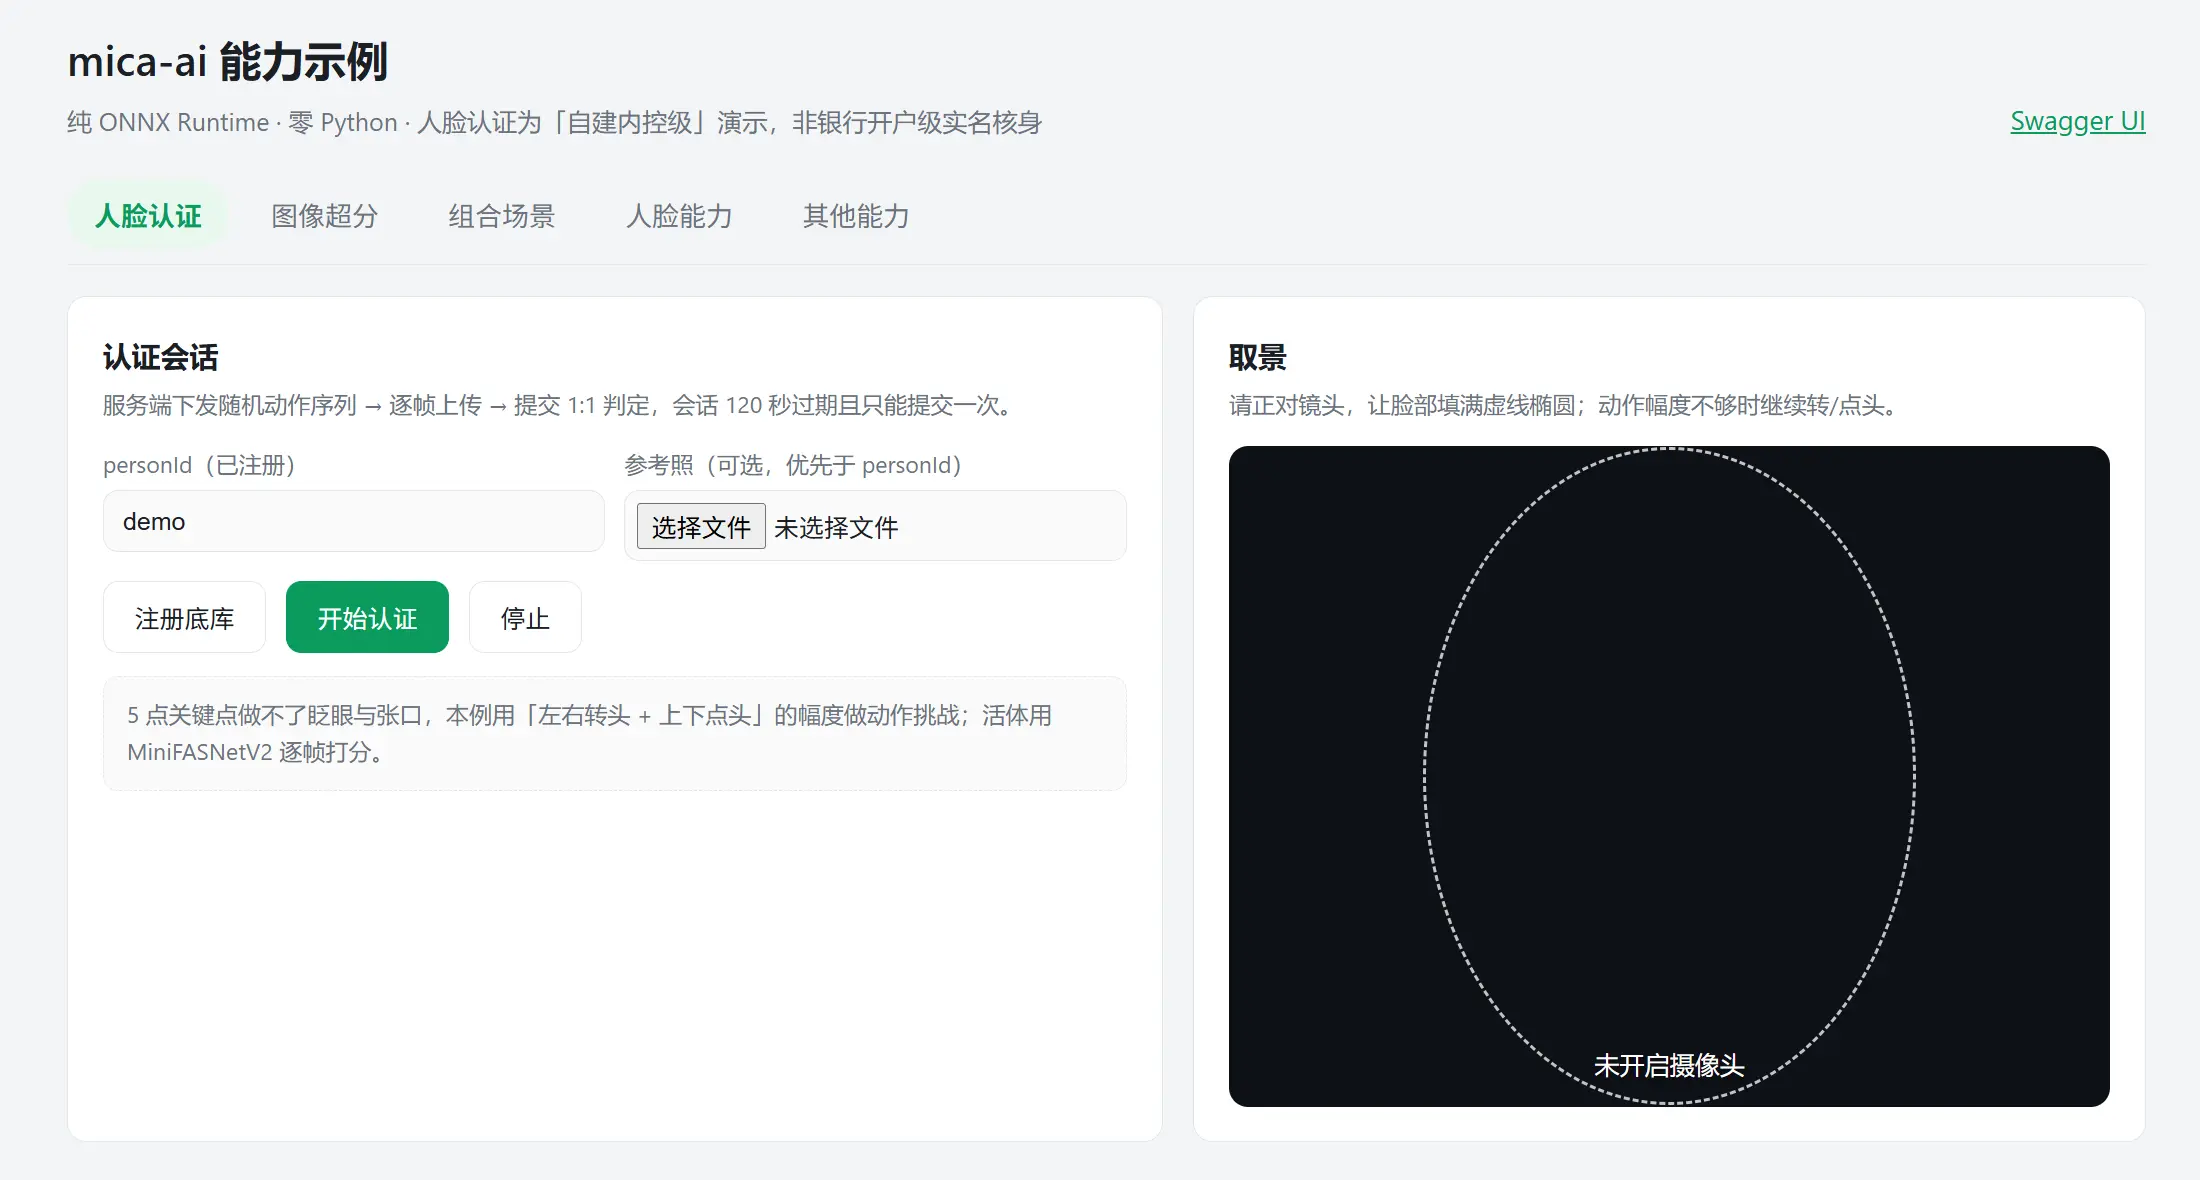
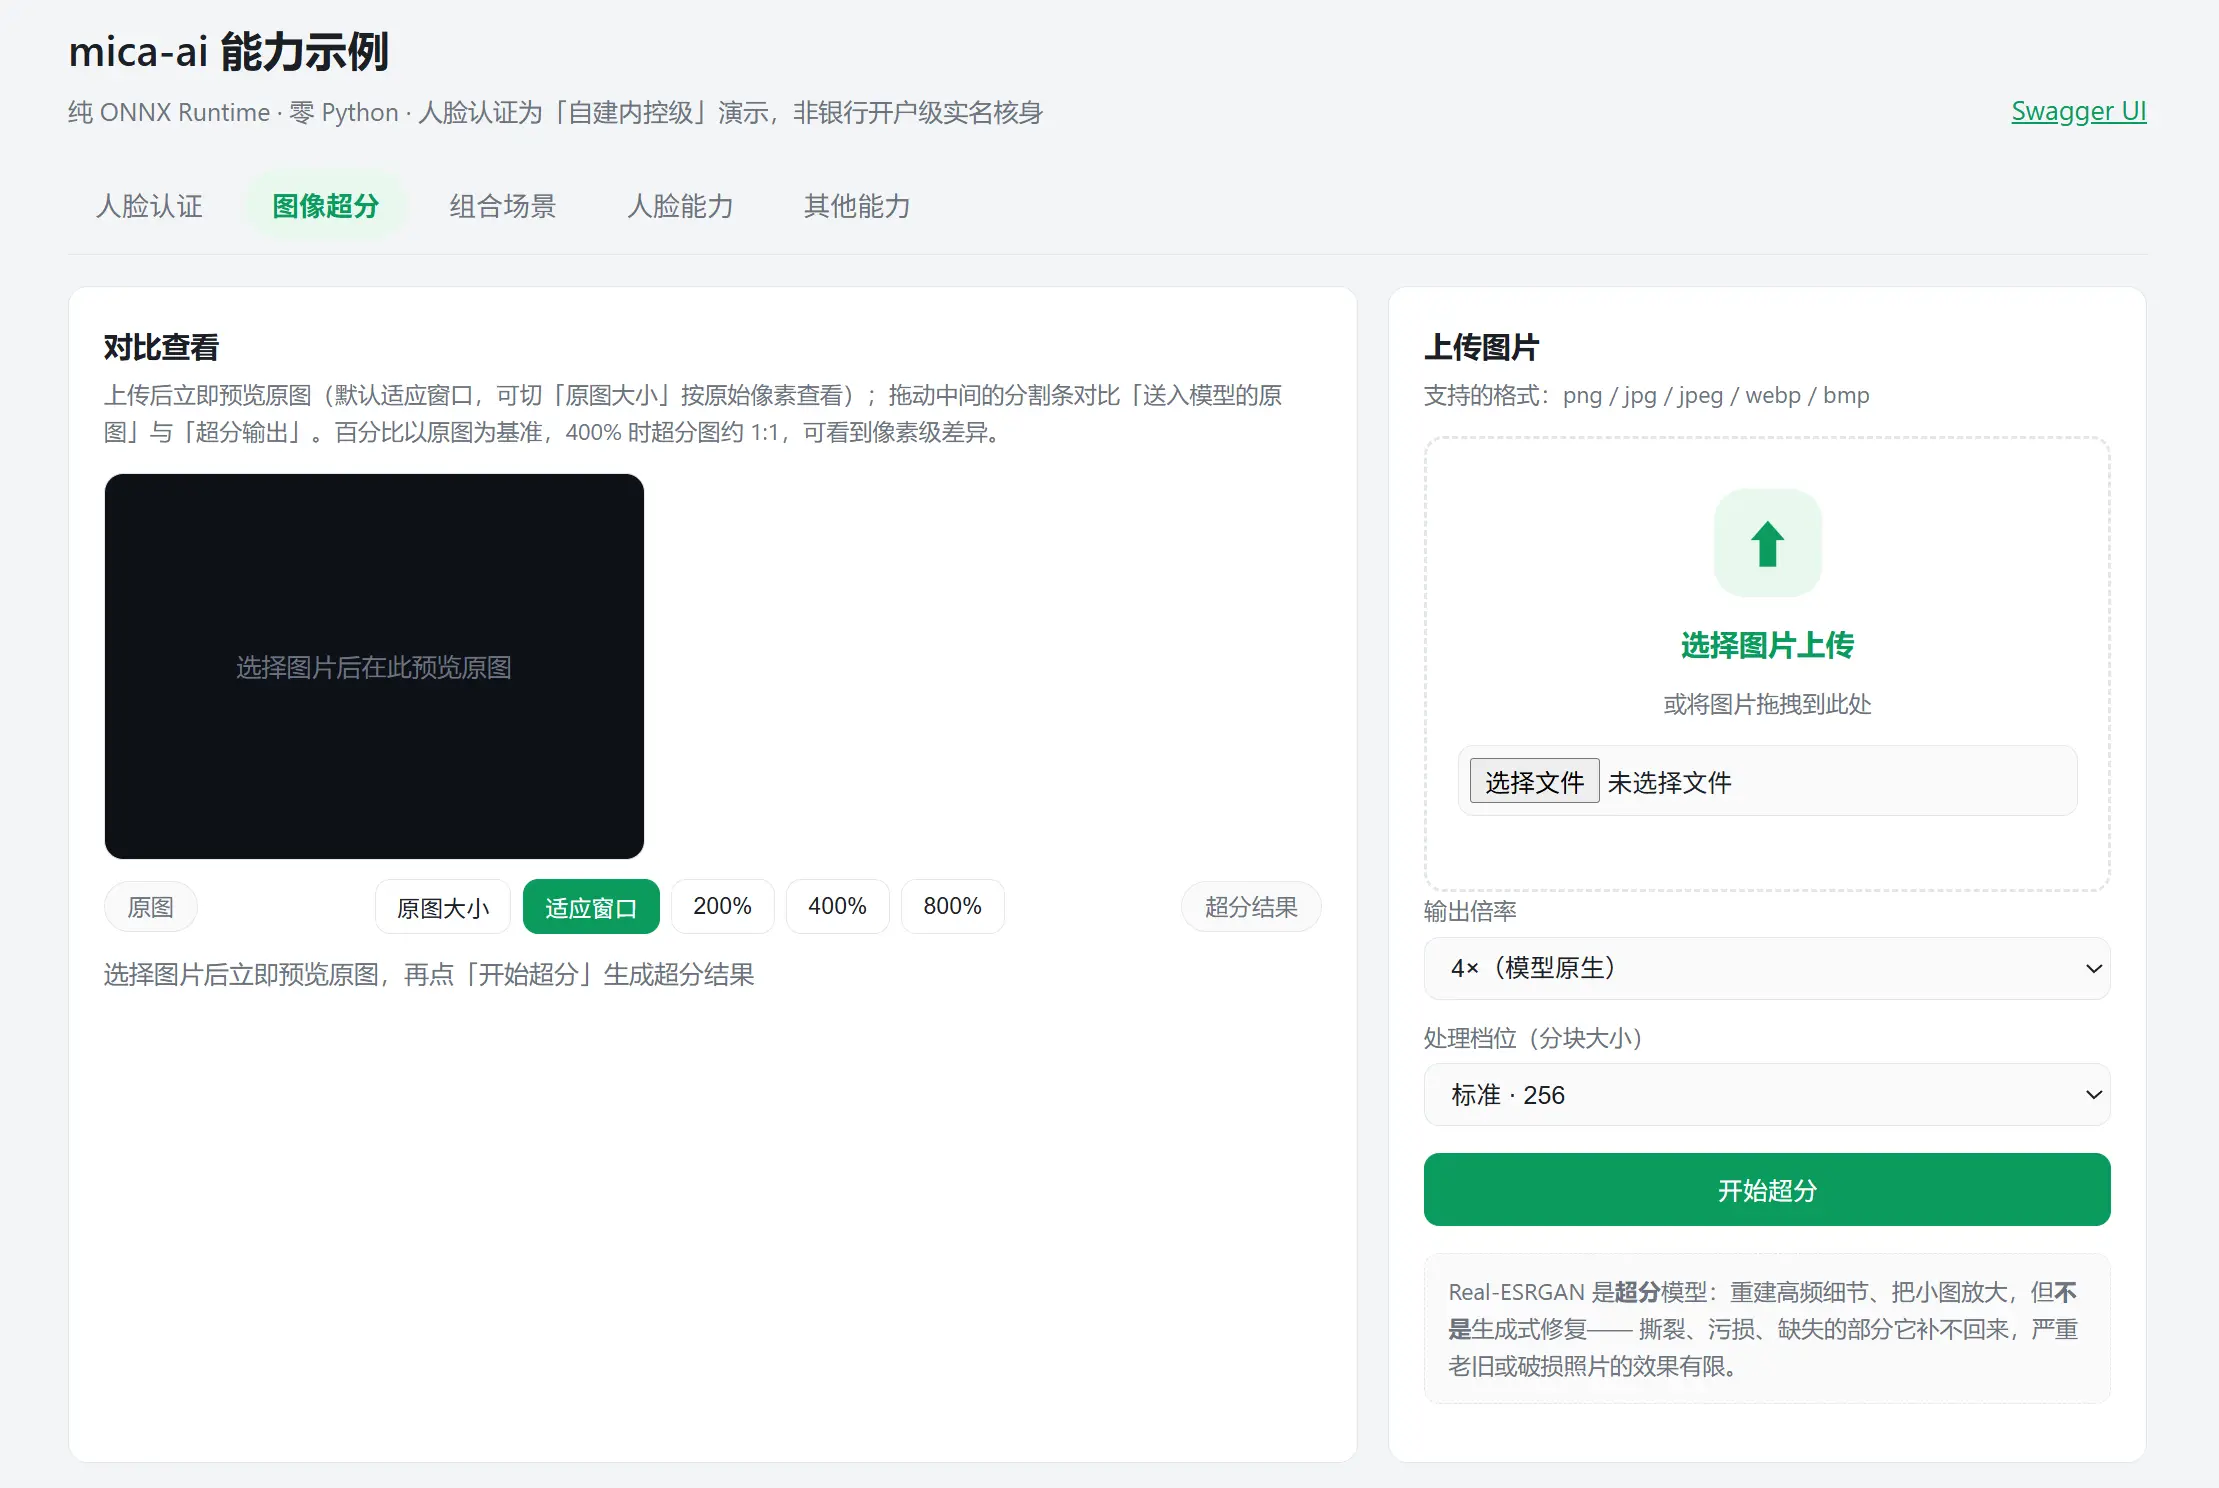
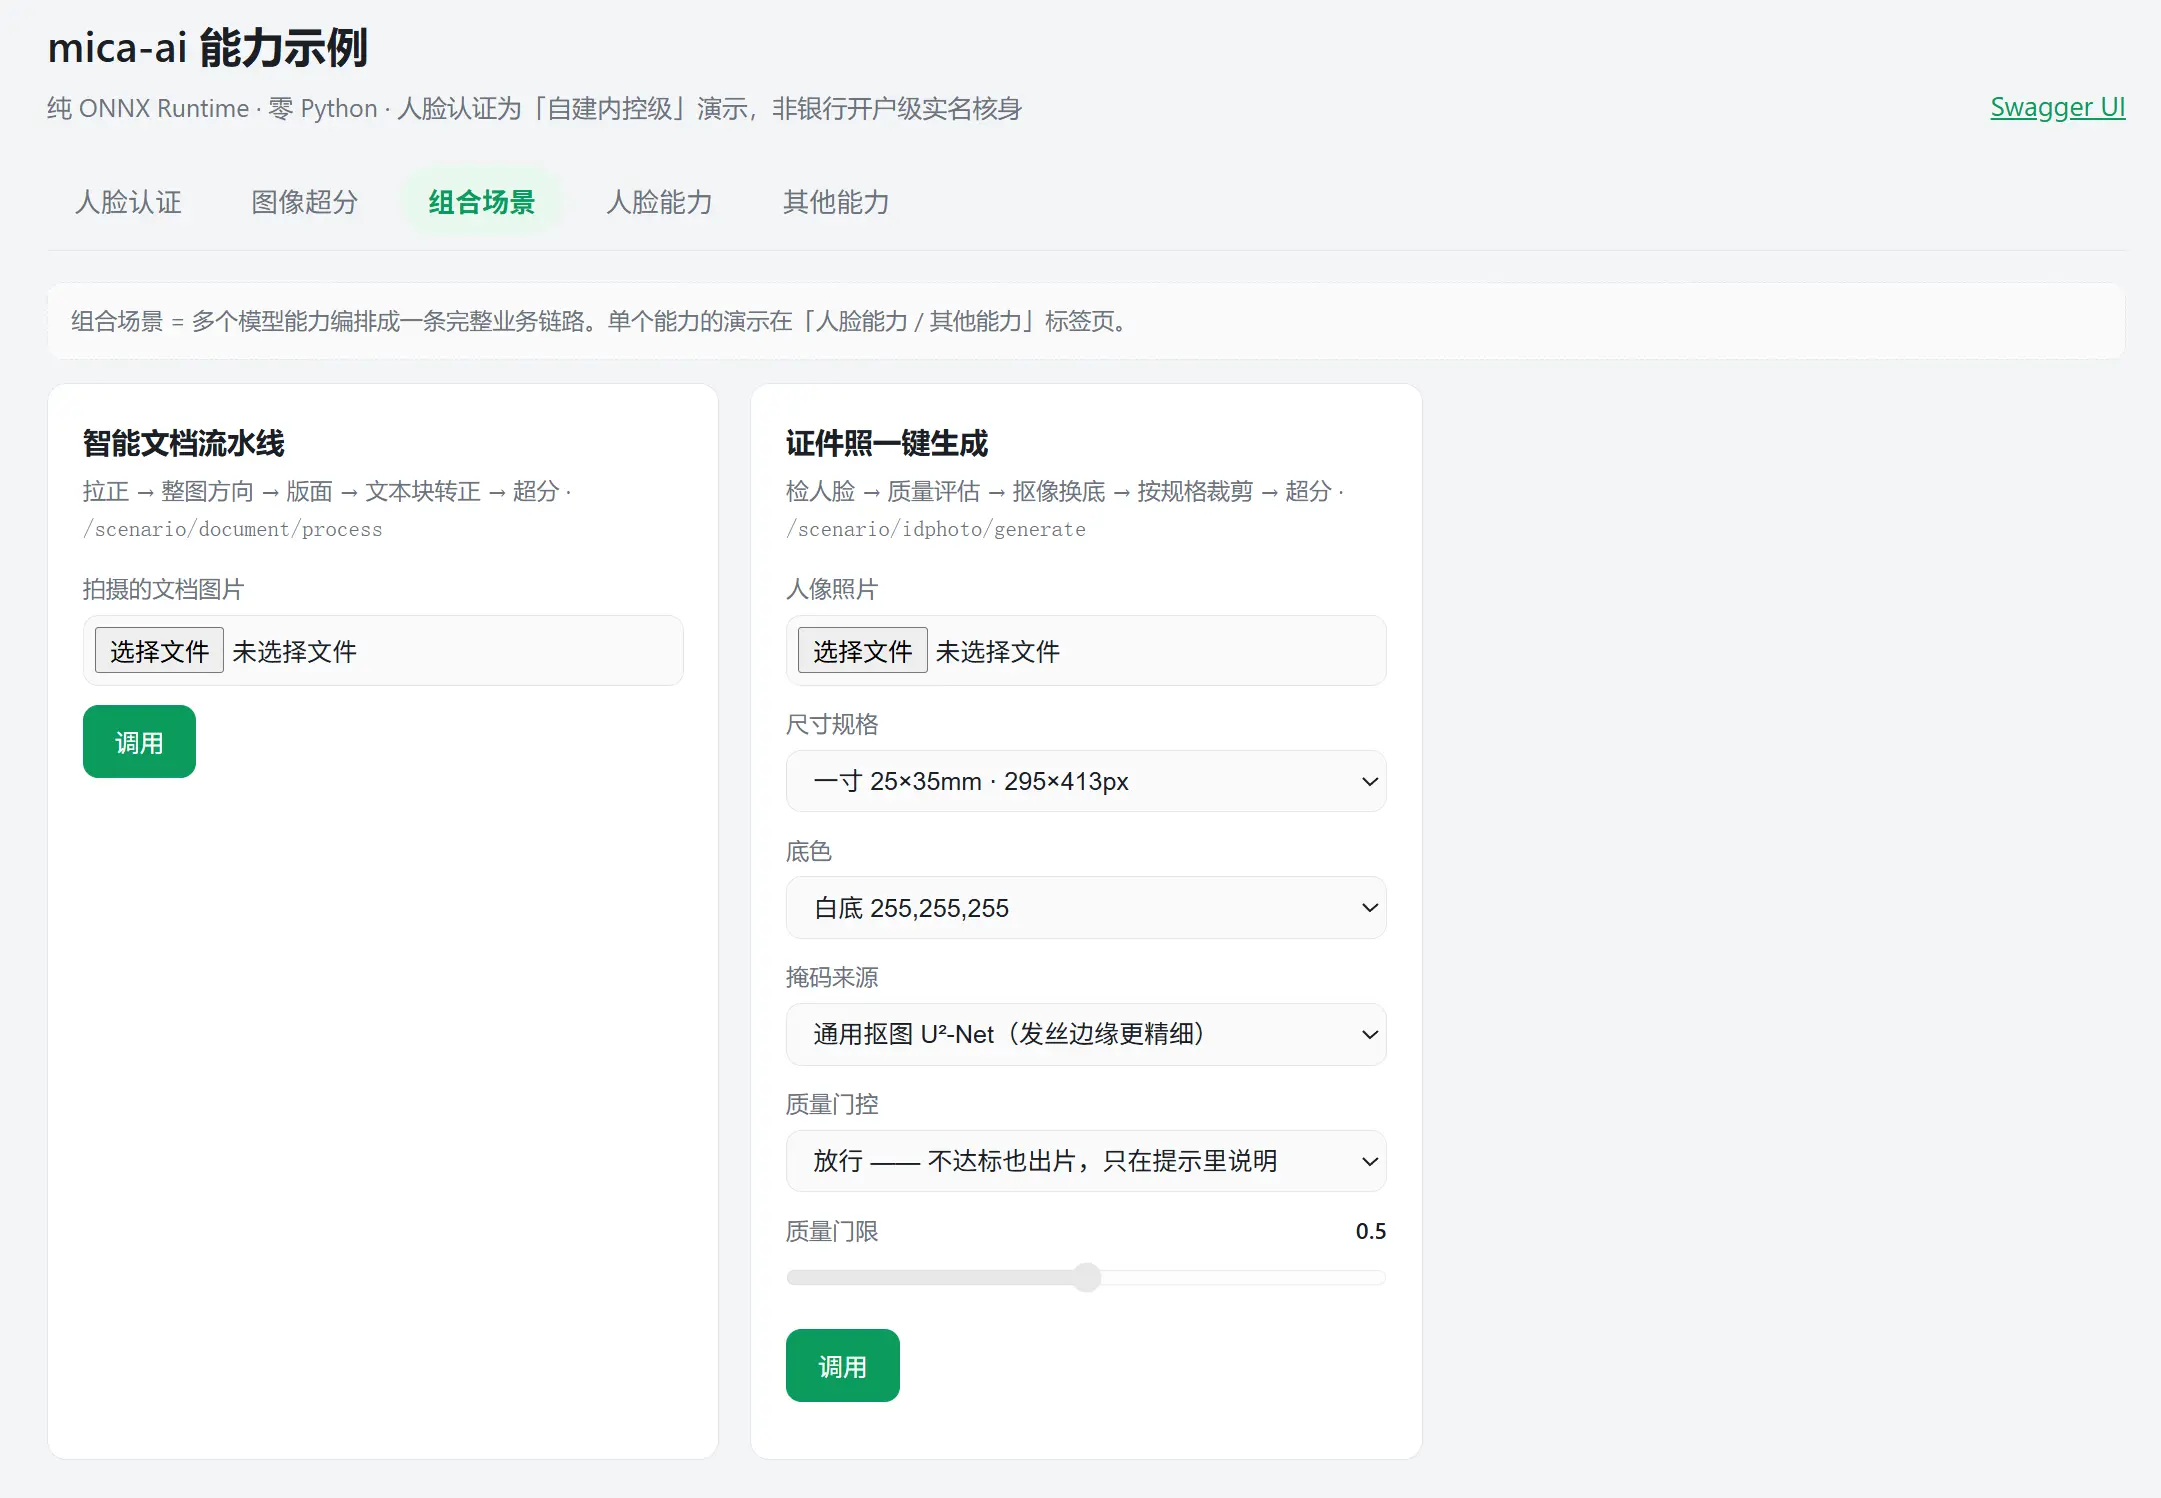
mica-ai-example 是一个完整的 Spring Boot 示例工程,13 个能力全部有可视化页面:上传图片即测。人脸模块还带摄像头实时演示(活体 + 动作配合),超分模块支持拖拽上传与前后对比滑块。
# 从仓库根目录执行
mvn -pl mica-ai-example -am -DskipTests clean install
mvn -pl mica-ai-example spring-boot:run
启动后访问 http://localhost:8181(本文截图均来自该页面):
七、几个工程细节
- 模型随仓库分发:clone 下来即可跑,没有「先执行 download.sh」这一步;超过 50 MB 的模型(版面分析)放到了网盘,缺失时相关测试自动跳过,不影响其它模块
- 同族模型可插拔:契约一致的同族模型(U²-Net 族、PP-LCNet 轻量版等)只改
model-path即可切换,不改代码 - fail-fast 校验:模型路径必填、字符集与模型成对配置,配置错了启动就报,绝不等到线上输出一堆乱码结果
- JDK 8 兼容:最低 Java 8,适配存量业务系统;Spring Boot 2.7 起
八、适合谁,不适合谁
适合:内网 / 私有化部署、数据不能出域、中等并发、不想为一个能力再养一个 Python 团队的 Java 业务系统。
不适合:需要大模型(LLM)能力的场景,以及需要 GPU 集群级吞吐的训练 / 批量推理场景 —— 那些场景有更合适的工具,mica-ai 不打算变成它们。
相关链接
- mica-ai 文档:13 个模块的 API、配置项与模型清单
- 示例工程说明
- GitHub · Gitee · GitCode
- 站内相关:mica-ppocr 纯 Java 离线 OCR
用得上就点个 Star;需要补哪个模型、哪类版式,Issue 里说一声,PR 也随时欢迎。